

在台灣近 10 萬名「沒有心衰竭」的高血壓病人中,使用第三代 beta-blocker Nebivolol 的人,血壓與心率降得更多,而且全因死亡風險降 27%(HR 0.73)、主要心血管事件(MACE)降 19%(HR 0.81),明顯優於 carvedilol 與其他 beta-blocker。但這是「觀察性研究」,只能說「相關」,還不能說「因果」。
🌟 三個最值得記住的重點
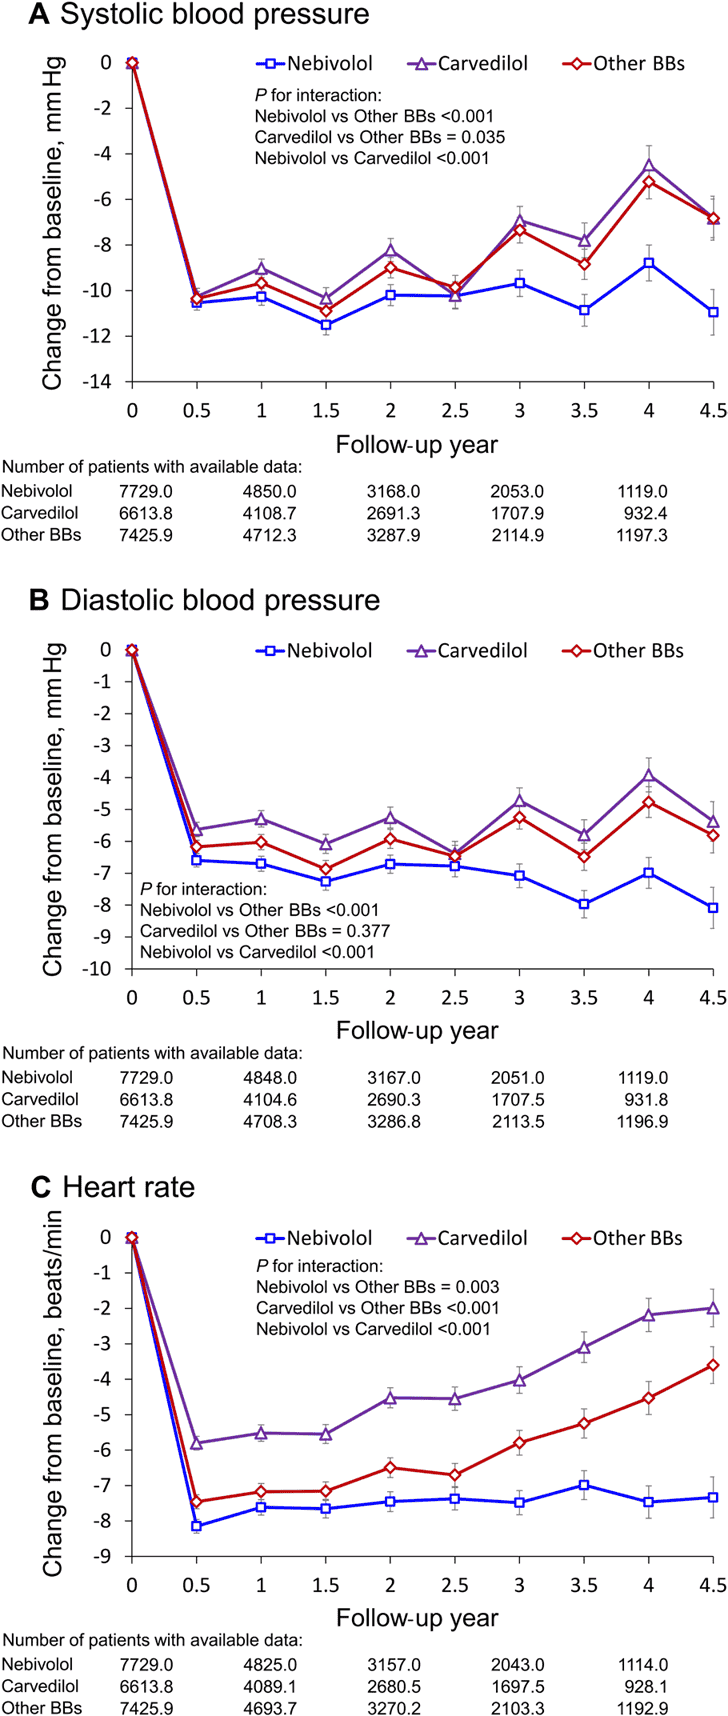
Nebivolol 收縮壓降 −11.0 mmHg、舒張壓降 −8.1 mmHg、心率降 −7.3 bpm,幾乎是其他 beta-blocker 的兩倍幅度(P for interaction < 0.001)。
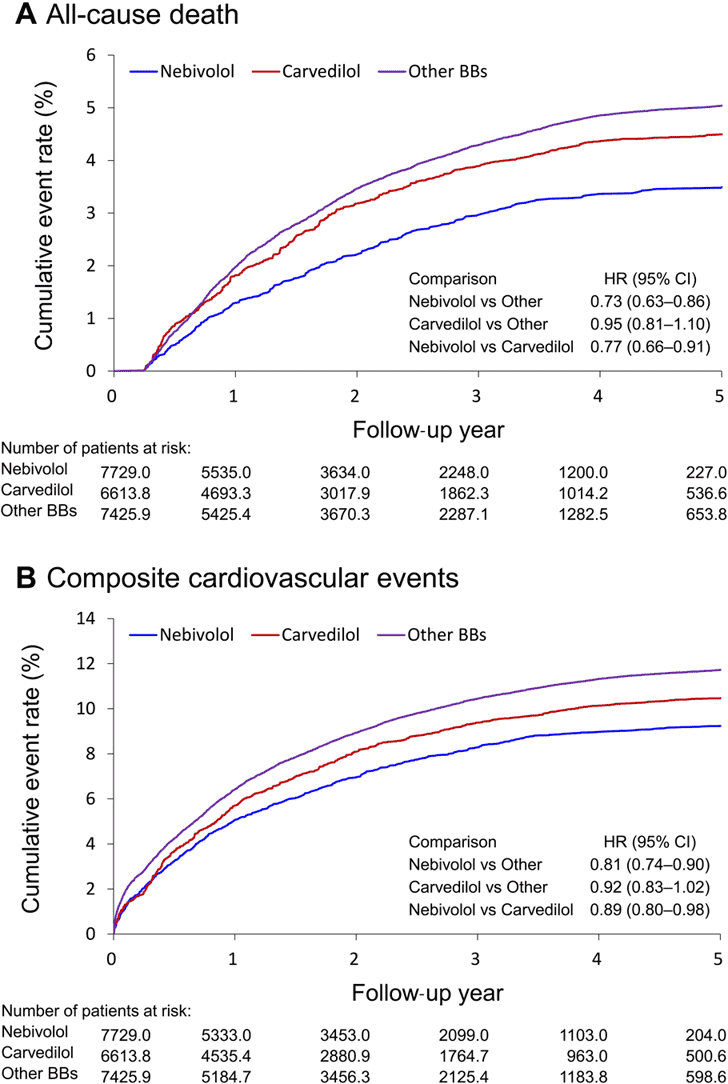
相較其他 beta-blocker,全因死亡 HR 0.73、心血管死亡 0.70、複合心血管事件 0.81,且事件曲線「早期就分開」並持續。
Nebivolol(中位 5 mg)、bisoprolol(2.5 mg)用得偏低,carvedilol(25 mg)反而偏高 —— 所以優勢不能用「劑量比較大」來解釋,較可能來自藥理特性。
🧪 研究速覽卡
🔬 這個研究是怎麼「設計」與「執行」的?
這是一篇回溯性世代研究(retrospective cohort):研究者並沒有主動「分派」病人吃哪種藥,而是回頭去翻長庚醫療體系的電子病歷資料庫(CGRD),把已經發生的處方與結果撈出來分析。理解它的設計,關鍵在三件事:怎麼選人、怎麼分組、怎麼定義「結果」。
① New-user design(新使用者設計):只收「第一次」開 beta-blocker 的人
Nebivolol 在長庚是 2018 年 11 月底才引進,是最新的一支。為了公平比較,研究只納入 2018/12–2023/12 之間第一次(new-user)被開立 nebivolol、carvedilol 或其他 beta-blocker 的高血壓病人,並把「第一次處方日」定為 index date(起始日)。這樣可以避免「老病人本來就吃很久、體質早被藥物改變」造成的偏差(即所謂 prevalent-user bias)。
② 分三組,並刻意把心衰竭排除掉
三組分法有藥理上的用意:nebivolol(β₁ 選擇性 + 一氧化氮血管舒張)與 carvedilol(非選擇性 β + α₁ 阻斷)藥理差很多,所以各自獨立成組;bisoprolol、atenolol、metoprolol 則合併成「其他 beta-blocker」代表日常常用藥。
最關鍵的設計是排除心衰竭或 LVEF < 40% 的病人。因為 beta-blocker 在心衰竭本來就有強烈的存活益處,而且心衰治療好轉後血壓/心率的變化會被「心功能改善」干擾。把心衰竭排掉,才能單純比較「在高血壓這個適應症下」三種藥的效果。其他排除條件包括:年齡 < 18 歲、缺基線生命徵象、服藥順從性差(90 天內使用 < 2 個月)、90 天內換藥、追蹤 < 90 天、失聯。
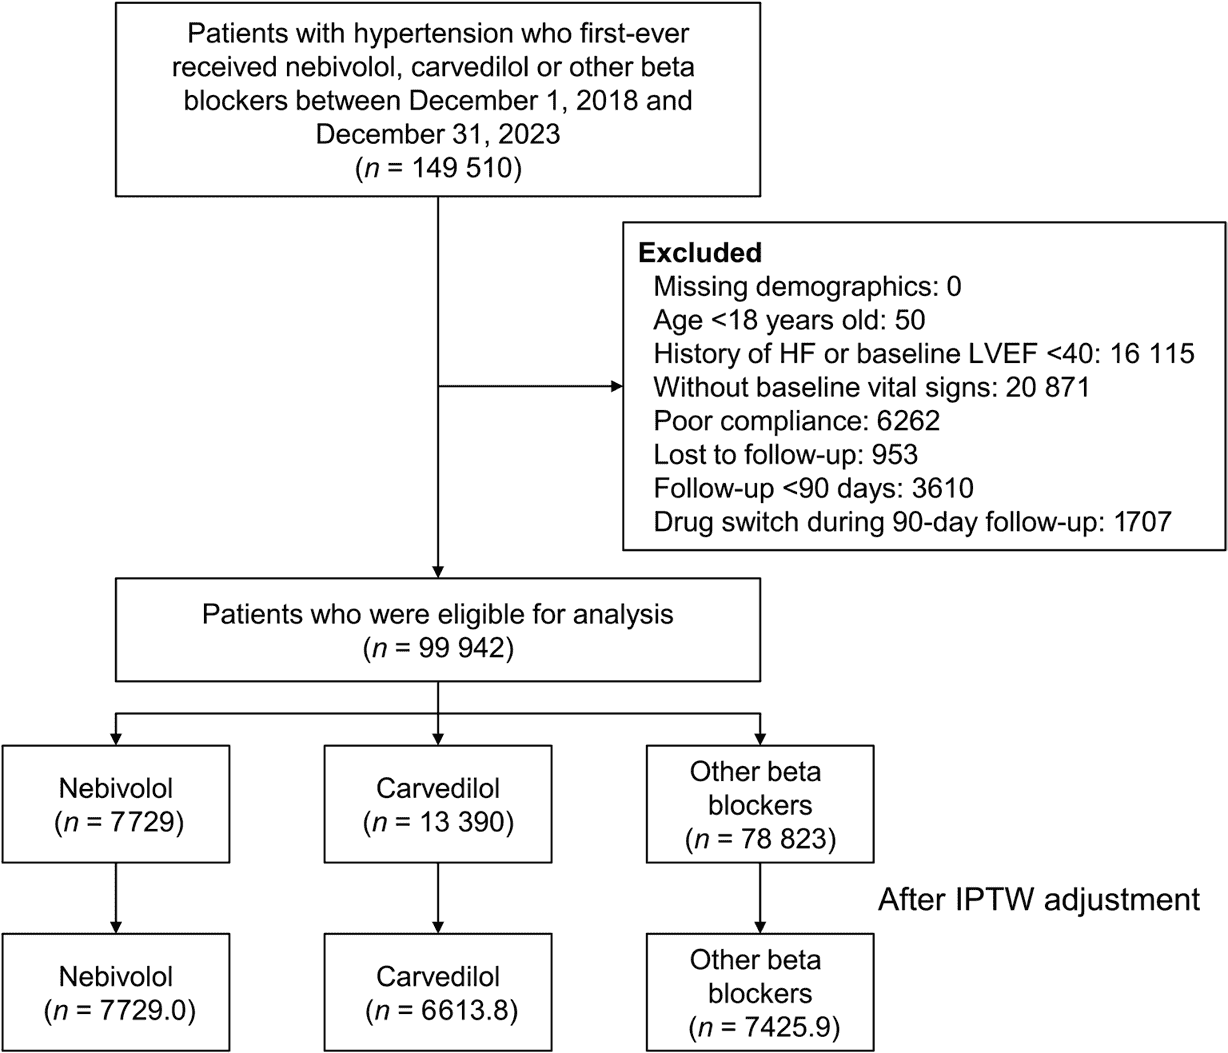
③ 怎麼定義「結果」?
主要終點是「生命徵象」:在門診每 6 個月量一次血壓、心率,畫出長達數年的變化軌跡(特別注意:病人一旦換藥,換藥後的生命徵象就不再納入該組分析,避免污染)。次要終點是「臨床硬終點」:急性心肌梗塞、中風(缺血性 + 出血性)、心衰住院、全因死亡,以及把它們組合起來的複合心血管事件(MACE)。死亡日期還串連了台灣死亡登記檔,資料相當可靠。
🧮 重頭戲:IPTW 到底怎麼「把三組拉平」?一步步拆解
觀察性研究最大的敵人是「適應症偏差 / 選擇偏差」:醫師會傾向把比較新、比較貴的 nebivolol 開給「比較年輕、比較健康」的病人。事實上加權前,nebivolol 組確實比較年輕、共病(冠心病、糖尿病、慢性腎病)較少、Charlson 分數較低。如果直接比,就算 nebivolol 沒效,光是病人底子好就會贏。IPTW 就是用來解決這個問題的工具。
IPTW 的核心邏輯:先算「傾向分數」,再用它的倒數當權重
算每個人的「傾向分數(propensity score, PS)」
用病人的所有基線資料(年齡、性別、BMI、共病、檢驗值、合併用藥…),去預測「這個人實際會被開到他這組藥的機率」。本研究三組,所以算的是「廣義傾向分數」。
用機器學習(GBM)來估,而不是傳統迴歸
作者用 Generalized Boosted Model(GBM,梯度提升樹):交互作用深度 3 層、最多 10,000 棵樹,停止規則看「共病最大標準化差異」。GBM 能自動處理大量變項、非線性與交互作用,通常比傳統 logistic regression 更會「抓平衡」。
權重 = 1 ÷(拿到自己實際那組藥的機率)
這就是「Inverse Probability(機率的倒數)」的由來。一個病人若「很典型、本來就該拿這支藥」→ 機率高 → 權重小(接近 1);若「很罕見、照理不該拿這支藥卻拿了」→ 機率低 → 權重變大,等於把這個稀有病人「放大」成好幾個人。
產生一個「虛擬世界(pseudo-population)」
加權之後,三組的年齡、共病、檢驗值分布會被拉到幾乎一樣 —— 就像「事後模擬出一場隨機分派試驗」。這也是為什麼 Table 1 加權後的人數變成小數(7,729.0 / 6,613.8 / 7,425.9):那是加權後的「等效人數」,不是真人頭數。
檢查有沒有拉平:看 MASD < 0.1
用最大絕對標準化差異(MASD)當尺。一般以 < 0.1 視為「兩組這個變項已可忽略差異」。本研究加權後所有變項 MASD 都 < 0.1,代表基線成功拉平(見下方 Table 1)。
① 先用最單純的「兩組」建立直覺
先把問題簡化成「只有兩組、只看年齡一個混淆因子」。下圖示範一個情境:醫師習慣把新藥開給底子好的年輕人,所以 nebivolol 組「天生較年輕」;經過「機率倒數加權」(權重 = 1 ÷ 拿到自己那組藥的機率)後,稀有的個案被放大、常見的被縮小,兩組的年齡組成最後被拉成一模一樣。
↑ 本文三組版:加權後三組的年齡、CAD、DM、CKD、Charlson、基線血壓與心率幾乎一致(全部 MASD ≤ 0.04),體質拉平後才比 outcome。
💊 先搞懂三種 beta-blocker 的藥理差異
要看懂這篇為什麼 nebivolol 會贏,得先知道這三類藥「機轉」差在哪:
| 藥物 | 世代 / 特性 | 關鍵藥理 | 給藥頻率 |
|---|---|---|---|
| Nebivolol | 第三代、高度 β₁ 選擇性 | 額外有一氧化氮(NO)介導的血管舒張,改善內皮功能、降低血管硬度,並有抗氧化潛力 | 一天一次 |
| Carvedilol | 非選擇性 β + α₁ 阻斷 | 有血管舒張作用,但半衰期短 → 需一天兩次,順從性可能較差 | 一天兩次 |
| Bisoprolol | β₁ 選擇性 | 單純 β₁ 阻斷,無 NO 機轉;與 nebivolol 同為一天一次 | 一天一次 |
真實世界劑量:nebivolol 是「以小博大」
| 藥物 | 本研究中位日劑量(IQR) | RCT 常用降壓劑量 |
|---|---|---|
| Nebivolol | 5.0 mg(2.5–5.0) | 5–10 mg qd |
| Carvedilol | 25.0 mg(12.5–37.5) | 12.5–25 mg bid |
| Bisoprolol | 2.5 mg(1.3–5.0) | 5–10 mg qd |
| Atenolol | 100 mg(50–100) | — |
| Metoprolol | 23.8 mg(23.8–23.8) | — |
📊 結果一:血壓與心率,nebivolol 降得又快又多
在平均約 4.5 年的追蹤中,三組的降幅如下(負值越大代表降越多):
| 指標(自基線變化) | Nebivolol | Carvedilol | 其他 BB |
|---|---|---|---|
| 收縮壓 SBP (mmHg) | −11.0 (−11.6 ~ −10.4) | −6.8 (−7.2 ~ −6.4) | −6.8 (−7.0 ~ −6.6) |
| 舒張壓 DBP (mmHg) | −8.1 (−8.5 ~ −7.6) | −5.4 (−5.7 ~ −5.0) | −5.8 (−6.0 ~ −5.5) |
| 心率 HR (bpm) | −7.3 (−7.8 ~ −6.9) | −2.0 (−2.4 ~ −1.6) | −3.6 (−3.9 ~ −3.3) |
線性混合效應模型確認:nebivolol 的 SBP、DBP 降幅顯著大於另外兩組(P for interaction < 0.001);心率控制也顯著較佳(P < 0.05),而 carvedilol 在「降心率」這項表現最差,軌跡最平。次組分析(依基線血壓/心率高低分層)與只用完整資料的敏感度分析,方向都一致。
📊 結果二:臨床硬終點,死亡與 MACE 顯著較低
下表是完整的臨床終點結果(事件率為每 100 人年;HR/SHR 含 95% CI,綠色粗體 = 達統計顯著,灰色 = 未達顯著):
| 終點 | Nebivolol 事件率 | Carvedilol 事件率 | 其他 BB 事件率 | Nebivolol vs 其他 BB | Nebivolol vs Carvedilol |
|---|---|---|---|---|---|
| 全因死亡 | 1.6 | 2.1 | 2.2 | 0.73 (0.63–0.86) | 0.77 (0.66–0.91) |
| 心血管死亡 | 0.5 | 0.5 | 0.7 | 0.70 (0.52–0.94) | 0.84 (0.61–1.16) |
| 非心血管死亡 | 1.2 | 1.6 | 1.6 | 0.75 (0.62–0.90) | 0.75 (0.62–0.91) |
| 複合心血管事件 MACE | 4.5 | 5.1 | 5.5 | 0.81 (0.74–0.90) | 0.89 (0.80–0.98) |
| 急性心肌梗塞 | 0.4 | 0.3 | 0.5 | 0.87 (0.62–1.21) | 1.21 (0.83–1.77) |
| 中風(總) | 1.0 | 1.1 | 1.1 | 0.92 (0.74–1.13) | 0.97 (0.78–1.21) |
| 心衰住院 | 1.0 | 0.9 | 1.0 | 1.01 (0.81–1.26) | 1.04 (0.83–1.31) |
數據摘自原文 Table 2。事件率單位 = 每 100 人年;非致命終點以 Fine–Gray SHR 估計(死亡為競爭風險)。
② Carvedilol vs 其他 BB 幾乎沒有差異(全因死亡 HR 0.95、MACE 0.92 皆未顯著)—— 也就是說,這篇的「贏家」很明確是 nebivolol,而不是「有血管舒張作用的 beta-blocker 都比較好」。
一張圖看懂 Nebivolol vs 其他 BB 的所有終點
從這張圖一眼看出:死亡(全因、心血管、非心血管)與複合心血管事件的 CI 都落在 1.0 左側(顯著有利);而單獨的心肌梗塞、中風、心衰住院三組之間沒有顯著差異(CI 跨過 1.0)。換句話說,nebivolol 的好處主要展現在「死亡」與「整體複合終點」。
💡 臨床意義與落地
這篇研究最直接的臨床訊息是:對於「有高血壓、但沒有心衰竭」的病人,如果決定要用 beta-blocker,nebivolol 在真實世界中同時帶來「更好的血壓/心率控制」與「更低的死亡與心血管事件」,可以列為這族群的優先 beta-blocker 選項之一。作者在 Clinical Perspective 也是這樣定調的。
背後可能的機轉(作者的詮釋):nebivolol 的 NO 介導血管舒張改善內皮功能、降低血管硬度;抗氧化潛力可能減少高血壓的標的器官損傷;高度 β₁ 選擇性降心率、降心肌耗氧;加上一天一次比 carvedilol 一天兩次更容易維持順從性。這些是傳統 beta-blocker 沒有的特性。
同時要放進大背景:近年(如 2023 年 Lancet 的觀點文)對「beta-blocker 是否該當高血壓第一線」本就有爭論 —— beta-blocker 在沒有強制適應症(如冠心病、心衰、心律不整)的單純高血壓,通常不是首選。這篇並非主張「高血壓都該先用 beta-blocker」,而是說「當你需要用 beta-blocker 時,這支可能是比較好的選擇」。
⚠️ 侷限與必須保留的地方
① 觀察性研究,無法證明因果:IPTW 只能平衡量得到的變項,殘留與未測量的干擾(醫師偏好、長期順從性、生活型態)仍可能存在 —— 死亡好處同時出現在「非心血管死亡」就是一個警訊。
② 診斷靠門診病歷編碼,未經影像/檢驗逐一確認,可能有錯分類。
③ 劑量無法標準化,後續調藥依臨床判斷。
④ 排除了心衰竭/LVEF<40% 病人,結論不能外推到心衰族群。
⑤ 只量診間血壓,無動態/居家血壓,可能漏掉白袍或隱匿性高血壓。
⑥ 未能評估病人自述的耐受性、代謝指標、不良反應(如暈厥、頭痛、周邊水腫)。
⑦ 大量缺失資料(51.5%),雖以 EM 補值且完整資料敏感度分析一致,仍是限制。
✅ 重點回顧
- 台灣 CGRD、近 10 萬名無心衰竭的高血壓病人,比較 nebivolol vs carvedilol vs 其他 beta-blocker。
- 用 IPTW(GBM 估傾向分數)把三組基線拉平(所有 MASD < 0.1),再比效果與結局。
- Nebivolol 降壓降心率最猛:SBP −11.0 mmHg、DBP −8.1 mmHg、HR −7.3 bpm(P for interaction < 0.001)。
- 硬終點:全因死亡 HR 0.73、心血管死亡 0.70、複合 CV 事件 0.81(vs 其他 BB,皆顯著)。
- 優勢不是劑量造成(nebivolol/bisoprolol 用得低、carvedilol 用得高),較可能來自藥理特性。
- Carvedilol vs 其他 BB 沒顯著差異 → 贏家明確是 nebivolol,而非「所有血管舒張型 BB」。
- 本質是觀察性研究,只能說相關;仍需前瞻性隨機試驗驗證。
📖 References
- Chang Y-C, Lee K-T, Ho W-J, Ling AW-C, Chu P-H. Comparative Effectiveness and Outcomes of Nebivolol Versus Other Beta Blockers in Patients With Hypertension: A Multicenter Cohort Study. J Am Heart Assoc. 2026;15:e044910. DOI: https://doi.org/10.1161/JAHA.125.044910(本文解析的主論文)
- Shin J, et al. Real-world efficacy and safety of nebivolol in Korean patients with hypertension (BENEFIT-Korea). J Hypertens. 2020;38:527–535. DOI: https://doi.org/10.1097/HJH.0000000000002296
- Manolis A, et al. Effect of nebivolol monotherapy or combination therapy on blood pressure: systematic review and meta-analysis of 91 RCTs. High Blood Press Cardiovasc Prev. 2025;32:7–31. DOI: https://doi.org/10.1007/s40292-024-00687-5
- Huck DM, Rosenberg MA, Stauffer BL. Nebivolol and incident cardiovascular events in hypertensive patients compared with nonvasodilatory beta blockers. J Hypertens. 2022;40:1019–1029. DOI: https://doi.org/10.1097/HJH.0000000000003109
- Messerli FH, Bangalore S, Mandrola JM. β blockers switched to first-line therapy in hypertension. Lancet. 2023;402:1802–1804. DOI: https://doi.org/10.1016/S0140-6736(23)01733-6
- McCaffrey DF, et al. A tutorial on propensity score estimation for multiple treatments using generalized boosted models. Stat Med. 2013;32:3388–3414. DOI: https://doi.org/10.1002/sim.5753(IPTW + GBM 方法學)
免責聲明:本文為學術論文之教育性解析,內容整理自上述已發表文獻,僅供醫療專業人員學術交流與知識整理之用,不構成對任何個別病人的診斷、處方或治療建議。臨床決策請依最新指引、完整臨床情境與主治醫師判斷為準。文中跨藥物之數據比較均來自單一觀察性研究,不可直接外推為因果或藥物優劣定論。
版權聲明:原始論文之著作權屬原作者與 Journal of the American Heart Association(American Heart Association)所有;文中圖(Figure 1–3)擷取自原文,僅作教育解析用途並標註來源。本解析文之中文撰述部分由 WeCareHeart 整理。


